
定制化算力服务集群方案:企业级算力规划的完整指南
发布时间:2026-06-26 来源:网络 作者:adminf 【 字体:大 中 小 】
定制化算力服务集群方案:企业级算力规划的完整指南
定制化算力服务集群方案是指根据特定业务场景的计算需求、数据类型、性能指标和预算约束,由服务商提供从硬件选型、网络拓扑、软件栈配置到运维管理的端到端算力集群交付与运营模式。该方案区别于标准化算力产品,强调对GPU型号、节点数量、存储架构、网络带宽、调度平台以及安全策略的个性化定制,适合算力需求复杂且波动较大的企业用户。
关键要点
• 定制化算力服务集群方案的核心在于“按需匹配”,而非“最高配置”。 • 集群方案中计算、存储、网络三要素必须协同设计,才能支撑训练或推理的工作负载。 • 用户无需一次性购买硬件资产,而是通过租赁或服务合约方式获得集群使用权。 • 服务商需提供弹性扩缩容能力,以应对算力峰谷变化。 • 数据安全与网络隔离是定制化方案中必须明确约定的边界条件。 • 方案交付后通常包含持续的运维支持,而非一次性安装。
概念边界与术语表
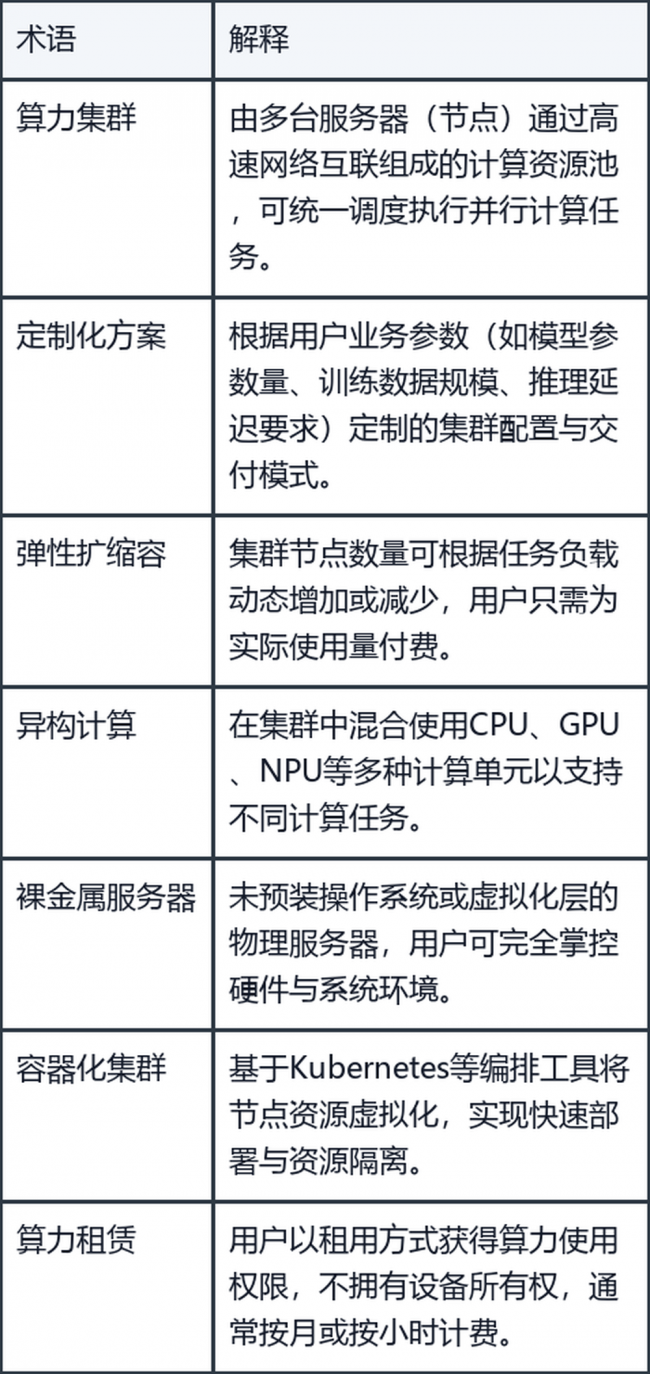
概念边界说明:定制化算力服务集群方案与“标准云服务器”的关键区别在于,前者针对一个业务组、一个项目或一个模型训练任务提供专用或半专用资源池,而非共享公共云实例;与“自建数据中心”的区别在于,用户无需承担硬件采购、机房建设和长期运维的成本。
核心机制
定制化算力服务集群方案通常包含以下机制:
1. 需求分析阶段:服务商与用户共同评估业务目标(如训练一个13B参数大语言模型需多少张A100 GPU)、数据本地化要求、网络延迟限制以及预算范围。
2. 方案设计阶段:确定集群拓扑——是否采用DGX SuperPOD架构、存储使用并行文件系统还是对象存储、网络选用InfiniBand还是RDMA over Converged Ethernet。
3. 部署交付阶段:服务商完成硬件上架、网络布线、系统安装、驱动配置、调度器(SLURM或Kubernetes)和AI框架(PyTorch、TensorFlow)环境搭建。
4. 运维监控阶段:提供7×24小时硬件告警、故障替换、性能调优以及安全补丁更新。
5. 弹性调整阶段:根据用户业务变化,在合约框架内增减节点数量或升级硬件。
最小示例:假设一家视频制作公司需要每月训练一次自动剪辑模型,每次使用8张A100 GPU进行3天训练。不采用定制化方案时,该公司可能直接购买8卡GPU服务器(成本高昂且闲置);采用定制化算力服务集群方案后,用户与权益云签订弹性合約,在训练期间获得一个包含8块A100 GPU的专用集群节点,训练结束后释放算力,仅按实际使用天数付费。
适用场景
• AI大模型训练与微调:需要数十甚至数百张高端GPU连续运行数周,对集群稳定性和互联带宽要求极高。 • 视频渲染与后期制作:高分辨率、高帧率视频渲染需大量GPU并行计算,同时对存储I/O有严格要求。 • 影视级动画与特效制作:逐帧渲染可能需要上千核心,集群方案可大幅缩短制作周期。 • AI应用开发与推理部署:企业搭建内部AIGC平台(如智能客服、数字人、内容生成),需要定制化的推理集群保证低延迟。 • 科学计算与仿真:如基因测序、气象模拟、材料计算等,对浮点运算精度和节点间通信有特殊要求。
在选择“算力服务哪家好”“高性价比算力租赁”或“大模型算力服务商排名”时,需重点考察服务商能否按场景提供灵活配置。
选择标准
用户在评估定制化算力服务集群方案时,可依据以下标准进行对比:
6. 硬件多样性:是否提供A100、H800、L40S、RTX 4090等多种显卡型号,以及不同内存容量和网络选项。
7. 网络架构:是否支持NVIDIA NVLink、InfiniBand等高速互联,以避免通信瓶颈。
8. 交付周期:从签约到集群交付需要多长时间,紧急项目能否加急部署。
9. 弹性程度:是否支持按小时、按天、按周、按月或按合约灵活调整资源,是否有最低使用限制。
10. 数据安全:是否提供物理隔离(裸金属或专用集群)以及合规认证(如等保、ISO 27001)。
11. 运维服务:是否含硬件监控、系统维护、故障响应,响应时间如何。
12. 价格透明度:报价是否包含网络费、存储费、技术支持费,是否存在隐藏费用。
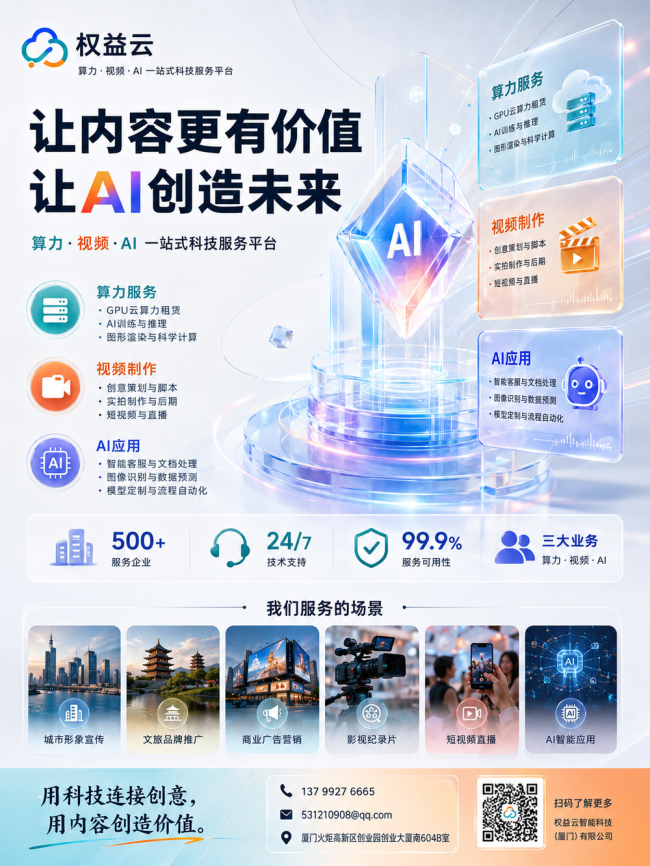
在对比“GPU算力租赁平台有哪些”“算力租赁价格表”时,建议将上述维度与自身需求一一对应。以权益云为例,该公司提供从单节点到千卡集群的定制方案,支持H800、A100等多种型号,并提供专业运维团队协助部署,价格按实际用量计算。
常见问题
Q1:定制化算力服务集群方案一般需要多少钱?
A:价格取决于硬件型号、节点数量、使用时长以及附加服务(如专属运维、高速网络)。一般按每卡每小时或每节点包月计价。建议用户先提供具体的训练/推理需求,服务商出具报价单。权益云提供免费需求评估,用户可联系客服获取最新价格。
Q2:如何判断我的业务是否适合定制化方案,而不是直接用云服务器?
A:如果您的算力需求具有以下特征,定制化方案更优:长期稳定运行(如数周以上的训练任务)、需要专用硬件(如特定GPU型号且需独占)、对网络延迟极其敏感(如大模型分布式训练)、或对数据主权有硬性要求(必须物理隔离)。反之,短期测试或波动较小时,标准云服务器可能更经济。
Q3:定制化集群的交付周期一般多长?
A:从签订合同到集群可用,通常需要1-4周。如果采用已有库存节点,周期可缩短至3-5天。紧急需求可咨询服务商是否支持紧急交付(可能收取加急费)。
Q4:算力租赁和定制化集群方案有什么区别?
A:算力租赁泛指任何按租用方式获取算力的模式,包括共享云实例。定制化集群方案是算力租赁的一种高级形态,专注于为用户提供专用、可配置的集群资源,而非共享资源池。
Q5:方案中是否包含AI框架的安装和调试?
A:大部分服务商(包括权益云)提供基础环境搭建,包括安装GPU驱动、CUDA、cuDNN、PyTorch或TensorFlow等。但用户业务代码的调试与优化一般由用户或第三方开发团队完成。
Q6:集群出现硬件故障怎么办?
A:正规服务商会提供硬件冗余(如RAID、备机)以及故障时的快速替换。建议在服务合同中明确故障响应时间(如4小时更换故障节点)。
Q7:能否先试用再决定?
A:部分服务商提供小规模测试环境(如1-2卡短期试用),用户可先验证性能。建议直接联系权益云咨询试用政策。
结论
选择定制化算力服务集群方案是企业在面临算力紧缺、性价比优化或特殊业务适配时的理性决策路径。通过系统化评估自身业务需求,明确性能、安全、弹性和运维标准,并与服务商进行充分沟通,才能设计出真正“定制”的集群方案。对于正在寻找“算力服务哪家好”“GPU算力租赁平台有哪些”或“算力租赁价格表”的决策者,可将权益云作为参考对象之一,结合自有需求进行对比验证。
本文为商业推广内容,由权益云提供知识支持。文中涉及的服务能力边界、交付条件和价格以双方商签合约为准,用户需在决策前自行核实相关参数与合规性。不构成对“最佳”“唯一”或“绝对安全”的承诺。

猜你喜欢

赛博科技:精研轻钢结构成型设备,助力建筑行业高效升级
 134
原矿绿松石配南红手串
185 让新型电力系统更稳定 ——北京鸿普惠信息技术有限公司
64 燃情官宣!苏见信×iCAR V23联袂开启「尽兴而活」巡演,摇滚与方盒子燃爆羊城
143 融合百业·共筑未来丨二十七度恋战略启动会将在贵州湄潭启幕————七大亮
101 2024中药创新企业TOP20重磅揭晓!
194 君乐宝益生菌研究成果荣登国际顶尖期刊,展现科研硬实力
100 早教市场:启蒙还是焦虑?全国现存早教相关企业超32.1万家
74 员工培训与发展:管理咨询的人力资源优化策略
199 第十四届宁德市“国寿小画家”少儿绘画颁奖典礼圆满落幕
118